

Mettre Perf Sentinel en route
Un mono-binaire auto-hébergé qui lit les traces OpenTelemetry que vos services émettent déjà, repère les I/O gaspillées et les chiffre en énergie et carbone. Ce guide va du premier run au quality gate CI.
Démarrage rapide
Cinq étapes, de la démo intégrée au daemon live. Rien à installer côté applications, mais vos spans doivent déjà porter le texte de la requête (db.statement) et l’URL cible (http.url) : les spans sans ces attributs sont écartés (le rapport les compte sur une entrée OTLP), auditez donc votre tracing d’abord avec perf-sentinel inspect. Perf Sentinel analyse les requêtes SQL, les appels HTTP et RPC sortants et les publications de messages. Les bases non SQL comme Redis, MongoDB ou Elasticsearch sont ignorées, tout comme le côté consommateur des messages.
demo --html est une vitrine complète : tous les onglets du tableau de bord sont remplis (Overview, Findings avec Explain en ligne, Carbon, pg_stat, mysql_stat, Diff et corrélations inter-traces synthétisées).
Sur dd-trace ? Faites le pont via le datadogreceiver du Collector, puis soit passez l’OTLP JSON écrit par son file exporter directement à analyze --input en batch (auto-détecté), soit alimentez le daemon watch en OTLP. Voir Vous venez de Datadog.
Avec Claude Code ? Le plugin Perf Sentinel écrit des tests d’intégration de performance pour votre changement en cours et les lance sous Perf Sentinel, et lit dans le Hub les findings de production pour les corriger par petits lots, chacun prouvé par un test de non-régression. Il demande avant chaque modification. Installez-le avec /plugin marketplace add Institut-du-Numerique-Responsable/perf-sentinel-claude, puis /plugin install perf-sentinel@perf-sentinel. Voir le plugin sur GitHub.
Installation
Au choix : crates.io, un binaire pré-construit, ou l’image conteneur. Les binaires Linux ciblent musl : statiques, ils tournent sur n’importe quelle distribution, y compris les images FROM scratch. Dans un pipeline CI, épinglez une version exacte et lisez le CHANGELOG avant chaque changement de version. L’identité des findings et les chiffres du quality gate peuvent bouger d’une version à l’autre.
Un chart Helm est publié pour les déploiements Kubernetes. Les images conteneur sont disponibles sur ghcr.io et Docker Hub.
Configuration
Déposez un .perf-sentinel.toml à la racine du dépôt. Les seuils pilotent le gate CI, et la détection ajuste la façon dont les anti-patterns sont signalés.
Référence CLI
18 sous-commandes dans un seul binaire. Lancez perf-sentinel <cmd> --help pour la liste complète des flags.
Le niveau CLI dans le synoptique →perf-sentinel demo --html demo.htmlperf-sentinel analyze --input traces.json --ci:4317 / HTTP :4318, /metrics Prometheus, /health, API de query.
perf-sentinel watch --listen-address 0.0.0.0perf-sentinel report --input traces.json --output report.htmlpg_stat_statements, classés par temps total.
performance_schema, classés par temps total.
card keygen, card render).
Toute la surface CLI en un schéma (18 sous-commandes, un pipeline, 11 sorties)
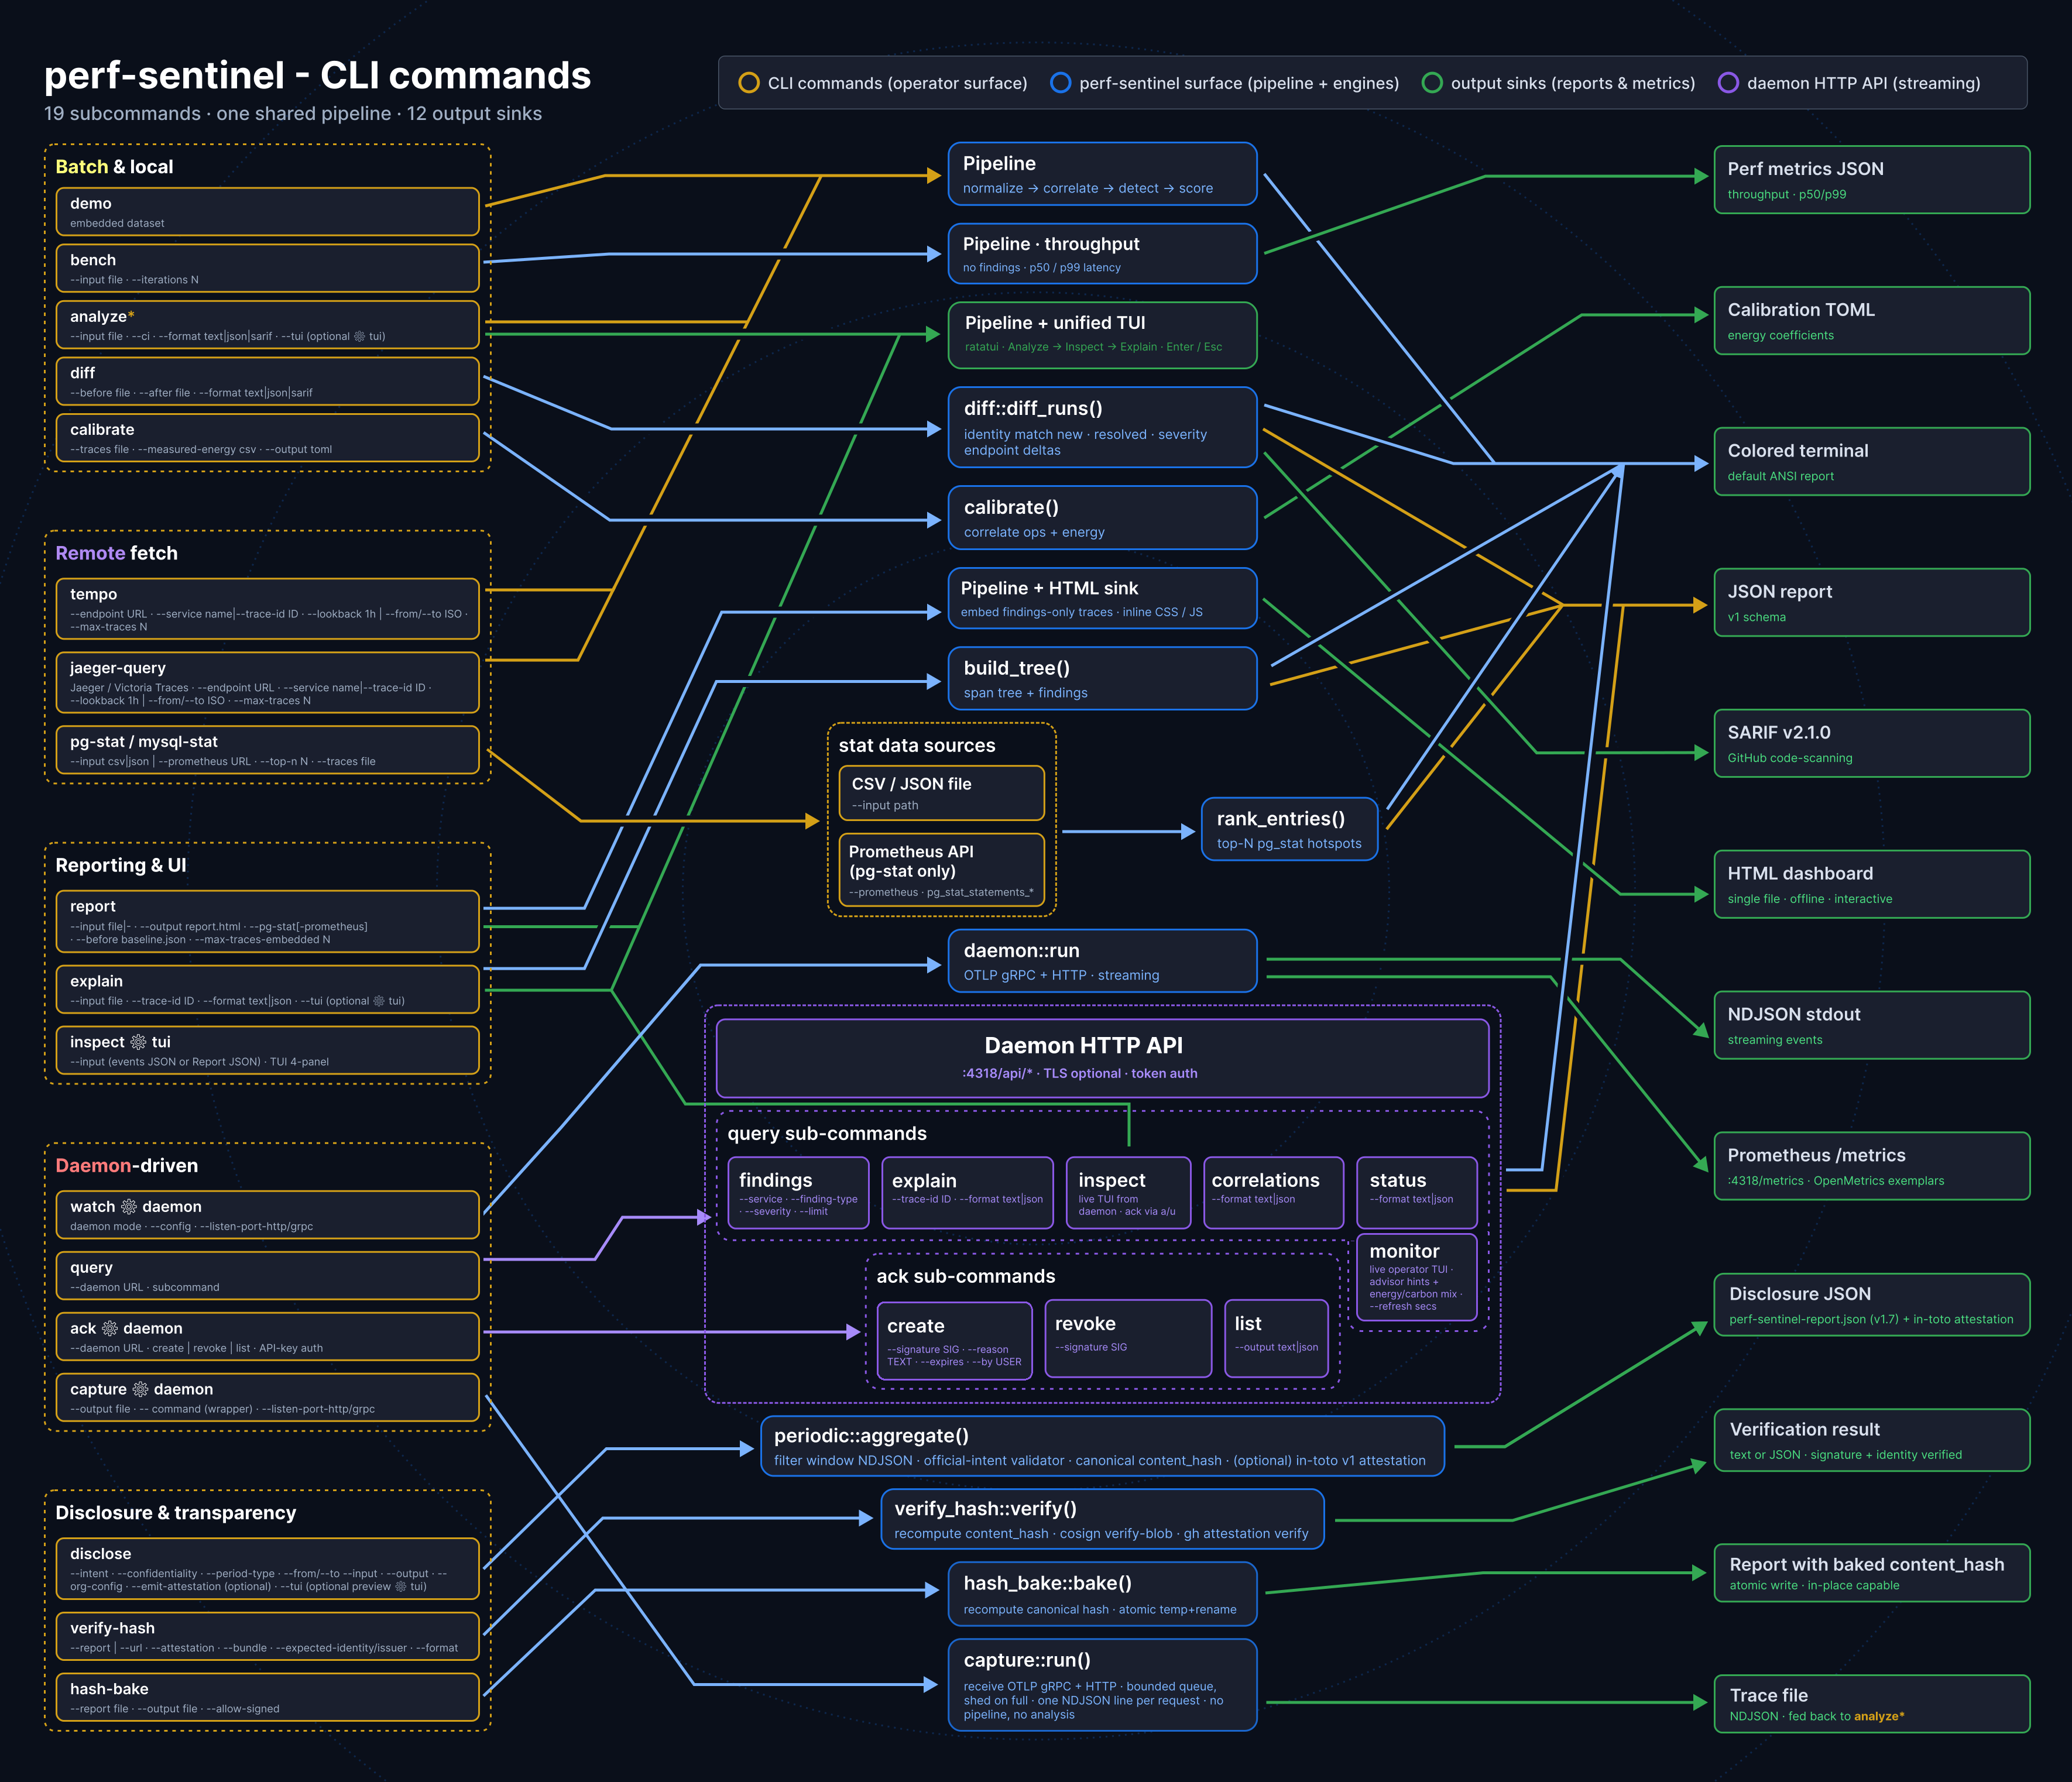
Formats d’entrée et de sortie
Les traces arrivent par fichier ou en OTLP live, et les résultats sortent en texte terminal, JSON/SARIF lisibles par machine, dashboard HTML, ou flux du daemon live. La sortie est déterministe : une entrée identique produit un JSON et un SARIF byte-identiques, les findings triés sur une clé stable plutôt que sur l’ordre d’une HashMap, donc un quality gate CI rend le même verdict à chaque exécution.
:4317 et HTTP :4318, ingérés par le daemon watch depuis votre OTel Collector ou SDK. Sur dd-trace ? Faites le pont via le datadogreceiver du Collector, voir Vous venez de Datadog.pg_stat_statementsperformance_schema/metrics Prometheus, sonde /health, API de query.Métriques GreenOps
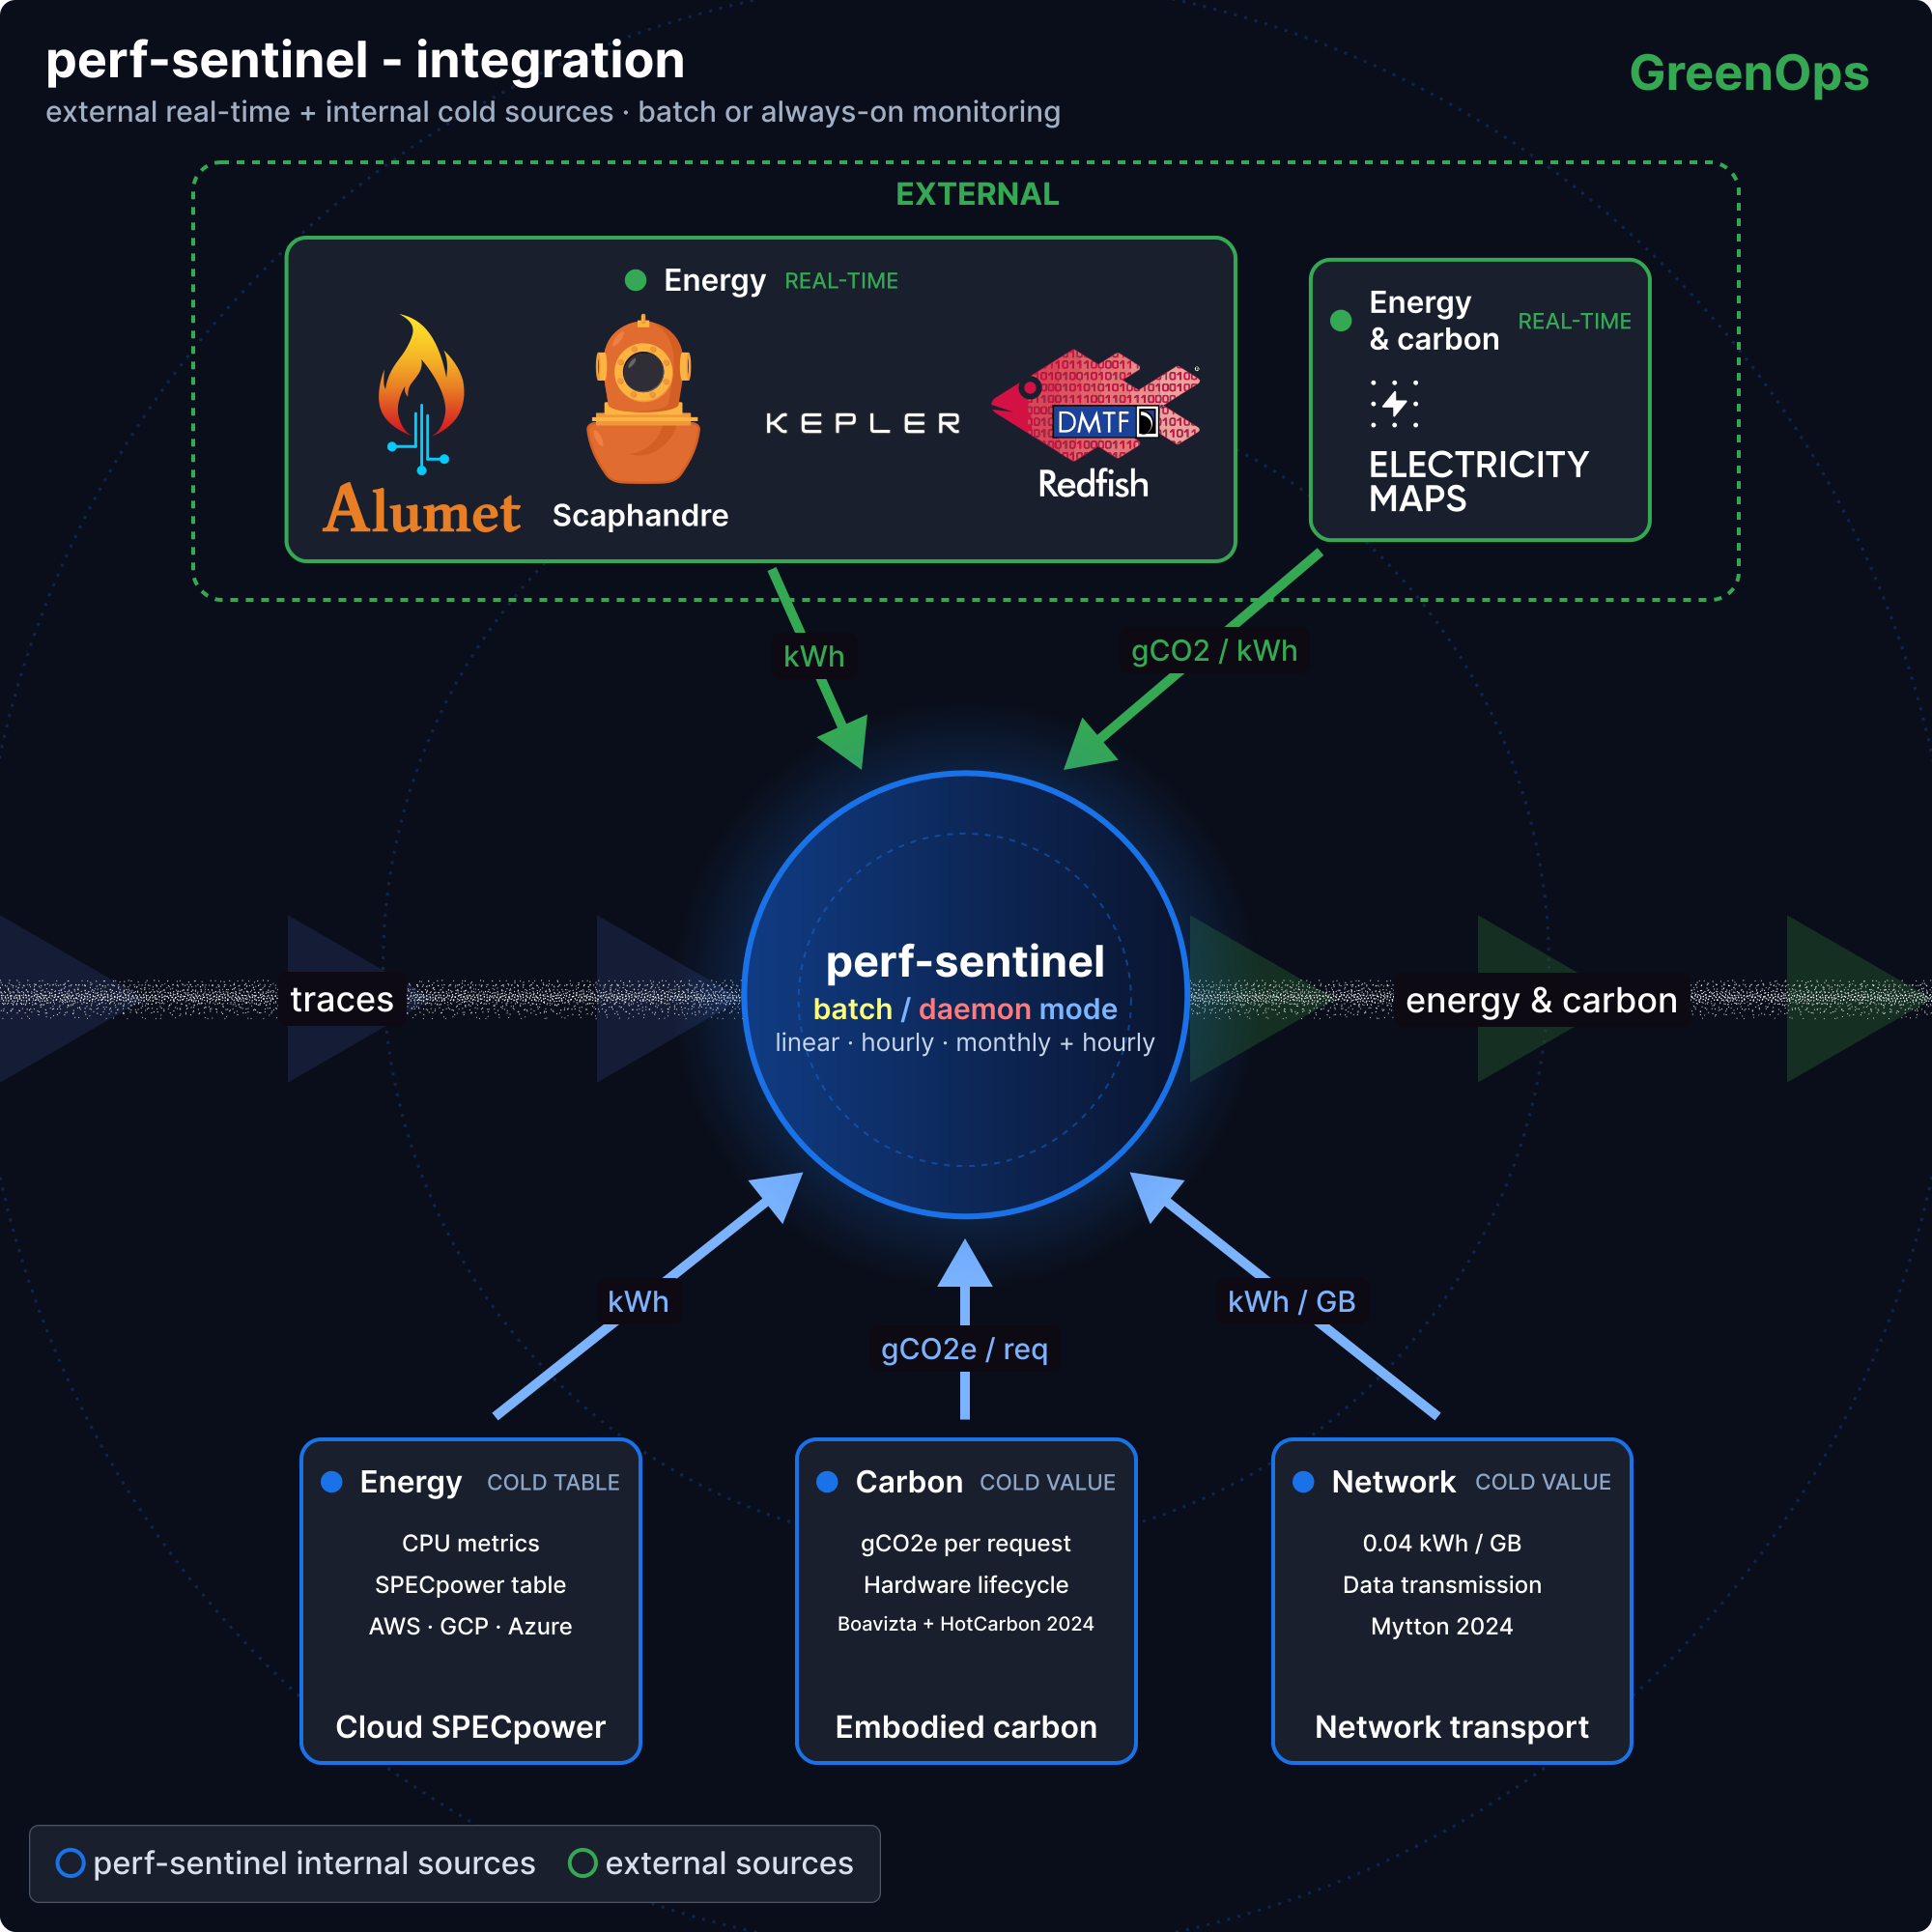
Chaque finding porte une lecture GreenOps. Les chiffres sont directionnels : ils servent à classer et suivre une tendance, pas à certifier (pour le moment).
Gaspillage, énergie et carbone, étages 5 à 7 du synoptique →io_intensity_band et io_waste_ratio_band sont stables entre versions. Les seuils numériques sous-jacents peuvent évoluer.Quelle source d’énergie sur quelle infrastructure
Aucun prérequis d’infrastructure : le modèle proxy I/O et les tables de réseau embarquées produisent des estimations dès la première trace, et les sources mesurées les raffinent là où l’infrastructure le permet. Quand plusieurs sources couvrent un service, la plus précise gagne automatiquement, service par service.
Le volet carbone chiffre les I/O détectées avec une méthodologie activity-based, intensité grid horaire par région (profils embarqués issus d’ENTSO-E, de l’EIA et d’autres, ou en direct depuis Electricity Maps ou huit opérateurs de réseau comme RTE et NESO), carbone embarqué bottom-up (Boavizta et HotCarbon 2024) et disclosures signées Sigstore vérifiables par hash.
Il convient comme source primaire de données pour une plateforme de comptabilité carbone horizontale, ou comme outil de contrôle interne pour les KPI d’émissions logicielles et la conformité RGESN.
Il n’est pas encore vérifié par tiers-partie pour un reporting CSRD ou GHG Protocol Scope 2/3 standalone, qui exige un audit par un organisme qualifié et l’intégration des scopes non-IT. Les chiffres CO₂ portent un encadrement ~2× en mode proxy par défaut, plus serré avec une source d’énergie mesurée (Alumet ou Scaphandre RAPL, Kepler eBPF, Redfish BMC ou SPECpower cloud avec calibration). Sources et bornes : la précision des estimations et la méthodologie.
Énergie et carbone, vulgarisés →
Couplages concrets : passer les comptes I/O et estimations énergie par région à Watershed, Sweep, Greenly ou Persefoni comme activity data, ou utiliser Perf Sentinel directement pour démontrer la conformité RGESN (Référentiel Général d’Écoconception de Services Numériques, ARCEP/Ademe/DINUM 2024) sur les critères d’optimisation logicielle, où détection de N+1, appels redondants, caching et réduction du fanout correspondent aux critères concernés.
Pour les organisations qui souhaitent malgré tout publier une disclosure périodique non-réglementaire d’efficacité logicielle (JSON trimestriel ou annuel, signature Sigstore optionnelle, PDF pour les lecteurs sans outil, publiable sur PerfSentinelHub, volontairement écartée du chemin de démarrage principal), le workflow optionnel perf-sentinel disclose est documenté dans le guide de divulgation.
Performance
perf-sentinel bench ne chronomètre que le pipeline d’analyse (normalize → correlate → detect → score), mono-thread, sur jeux de données synthétiques : le coût pur du pipeline, pas un débit de bout en bout ni un benchmark du daemon sous charge.
- x86 : GCP c3-standard-8 (Xeon 8481C à 2,70 GHz, 8 vCPU), mesuré en juin 2026.
- M4 : Mac mini M4 Pro (12 cœurs, 24 Go), mesuré le 2026-06-08.
Les deux mesures portent sur la version 0.8.5 (musl+mimalloc sur x86, allocateur système en natif sur M4). Le pipeline a évolué depuis. Avec les artefacts natifs, le M4 Pro tient environ 2,1× un vCPU 8481C (2,14× répété, 2,08× varié). p50 / p99 = latence par évènement sur 10 itérations. Mémoire du daemon : ~17 Mo RSS au repos, pic ~190 Mo sous une charge d’ingestion soutenue de ~1,0M évt/s (contre 237 Mo sur 0.6.1, sous le plafond de 250 Mo). Ce sont des chiffres de labo avec un anneau de findings vide, ce n’est pas ce qui dimensionne un pod : la note mémoire ci-dessous donne les chiffres de production. Rust édition 2024, rustc 1.96.0. Reproduire avec perf-sentinel bench --help.
Méthodologie du bench (périmètre du chrono, jeux de données)
La lecture du fichier, le parsing JSON et l’ingestion ont tous lieu avant le démarrage du chrono, et les lots d’entrée sont clonés en amont. Le pipeline est mono-thread (pas de rayon), le nombre de cœurs ne change donc pas le débit. Les deux jeux comptent 44 043 évènements synthétiques, construits en dupliquant la fixture de démo. L’un répète le même motif et l’autre utilise du SQL aléatoire par requête. Cela isole le débit du pipeline mais ne reflète pas la diversité d’une vraie production.
Détail par allocateur sur la même puce
L’artefact musl x86 est lié à mimalloc tandis que l’artefact macOS arm64 utilise l’allocateur système. Les binaires diffèrent donc par l’allocateur autant que par l’ISA. Sur le même M4 Pro, le build musl+mimalloc (l’artefact linux/arm64 en conteneur Docker) atteint ~1,39M / ~1,51M évt/s contre ~1,23M / ~1,33M en natif, ~13 % plus vite que l’allocateur natif de macOS, confirmant l’allocateur comme cause principale du débit plus élevé en Docker. À build équivalent, le M4 Pro fait ~2,4× le x86 8481C (2,41× répété, 2,36× varié).
Mémoire : repos en labo vs daemon en production
bench affiche rss_peak_bytes, mais cette valeur est dominée par les lots d’entrée pré-clonés (10 itérations × 44 043 évènements), ce n’est pas l’empreinte du daemon. Ce rss_peak n’est pas non plus comparable entre OS (RSS courant via /proc sous Linux, pic via getrusage sous macOS). Profilé séparément sur le même M4 Pro dans une VM Docker Desktop linux/arm64, le daemon tourne à ~17 Mo au repos en musl+mimalloc (~10 Mo en natif, mimalloc échange un peu de RSS contre de la vitesse) et culmine à ~190 Mo sous une charge soutenue de ~1,0M évt/s, contre 237 Mo sur 0.6.1, sous le plafond de 250 Mo.
Un daemon en production a un tout autre profil. Sur un StatefulSet Kubernetes en 0.19.0 avec max_retained_findings = 100000, process_resident_memory_bytes démarre vers 88 Mo, monte pendant que l’anneau se remplit puis se stabilise : sur 7 jours, médiane à 980 Mo et p90 à 1,2 Go qui est le plafond des journées normales, avec une excursion isolée à 1,8 Go redescendue sur la journée suivante, aucun redémarrage ni OOM sous une limite de 2 Gio et une requests de 1 Gio. Le débit d’ingestion ne pilote pas cette mémoire (médiane 30 évt/s, p95 520 évt/s, pic 2,1k évt/s). Ce sont les findings retenus qui la pilotent, à environ 3 à 6 Ko de RSS chacun selon la quantité de preuves qu’ils portent. Dimensionnez donc le pod à partir de max_retained_findings, pas à partir du chiffre au repos : quelques centaines de Mo à la valeur par défaut de 10000, 1 à 2 Go à 100000, et 0 restitue tout le stockage quand l’API de requêtage est désactivée.
Comment ça se compare
La niche de Perf Sentinel : léger, agnostique du protocole, natif CI/CD et carbon-aware, pas un remplacement d’une suite d’observabilité complète.
Le chiffre Datadog est celui que Datadog publie pour son Agent 7.34 sur une instance c5.xlarge, hors traceurs chargés dans chaque service. New Relic ne publie pas de RSS pour ses agents APM, et Grafana dimensionne Alloy selon le volume de profils. Le chiffre de Perf Sentinel exclut de même l’instrumentation OTel qu’il lit. L’overhead réel dépend du périmètre d’instrumentation.
Acquittement de findings connus
Déposez un .perf-sentinel-acknowledgments.toml à la racine du dépôt pour supprimer les findings que l’équipe a acceptés : chacun reçoit une signature SHA-256, et ils sont filtrés de analyze / report / inspect / diff et ne comptent pas dans le quality gate. Les acks runtime contre un daemon live sont exposés via le CLI ack, le dashboard HTML live, le TUI, et le dashboard des findings, dont la colonne Ack ouvre la page d’acquittement d’un PerfSentinelHub qui relaie vers le daemon.
Flux d’acquittement →Déploiement
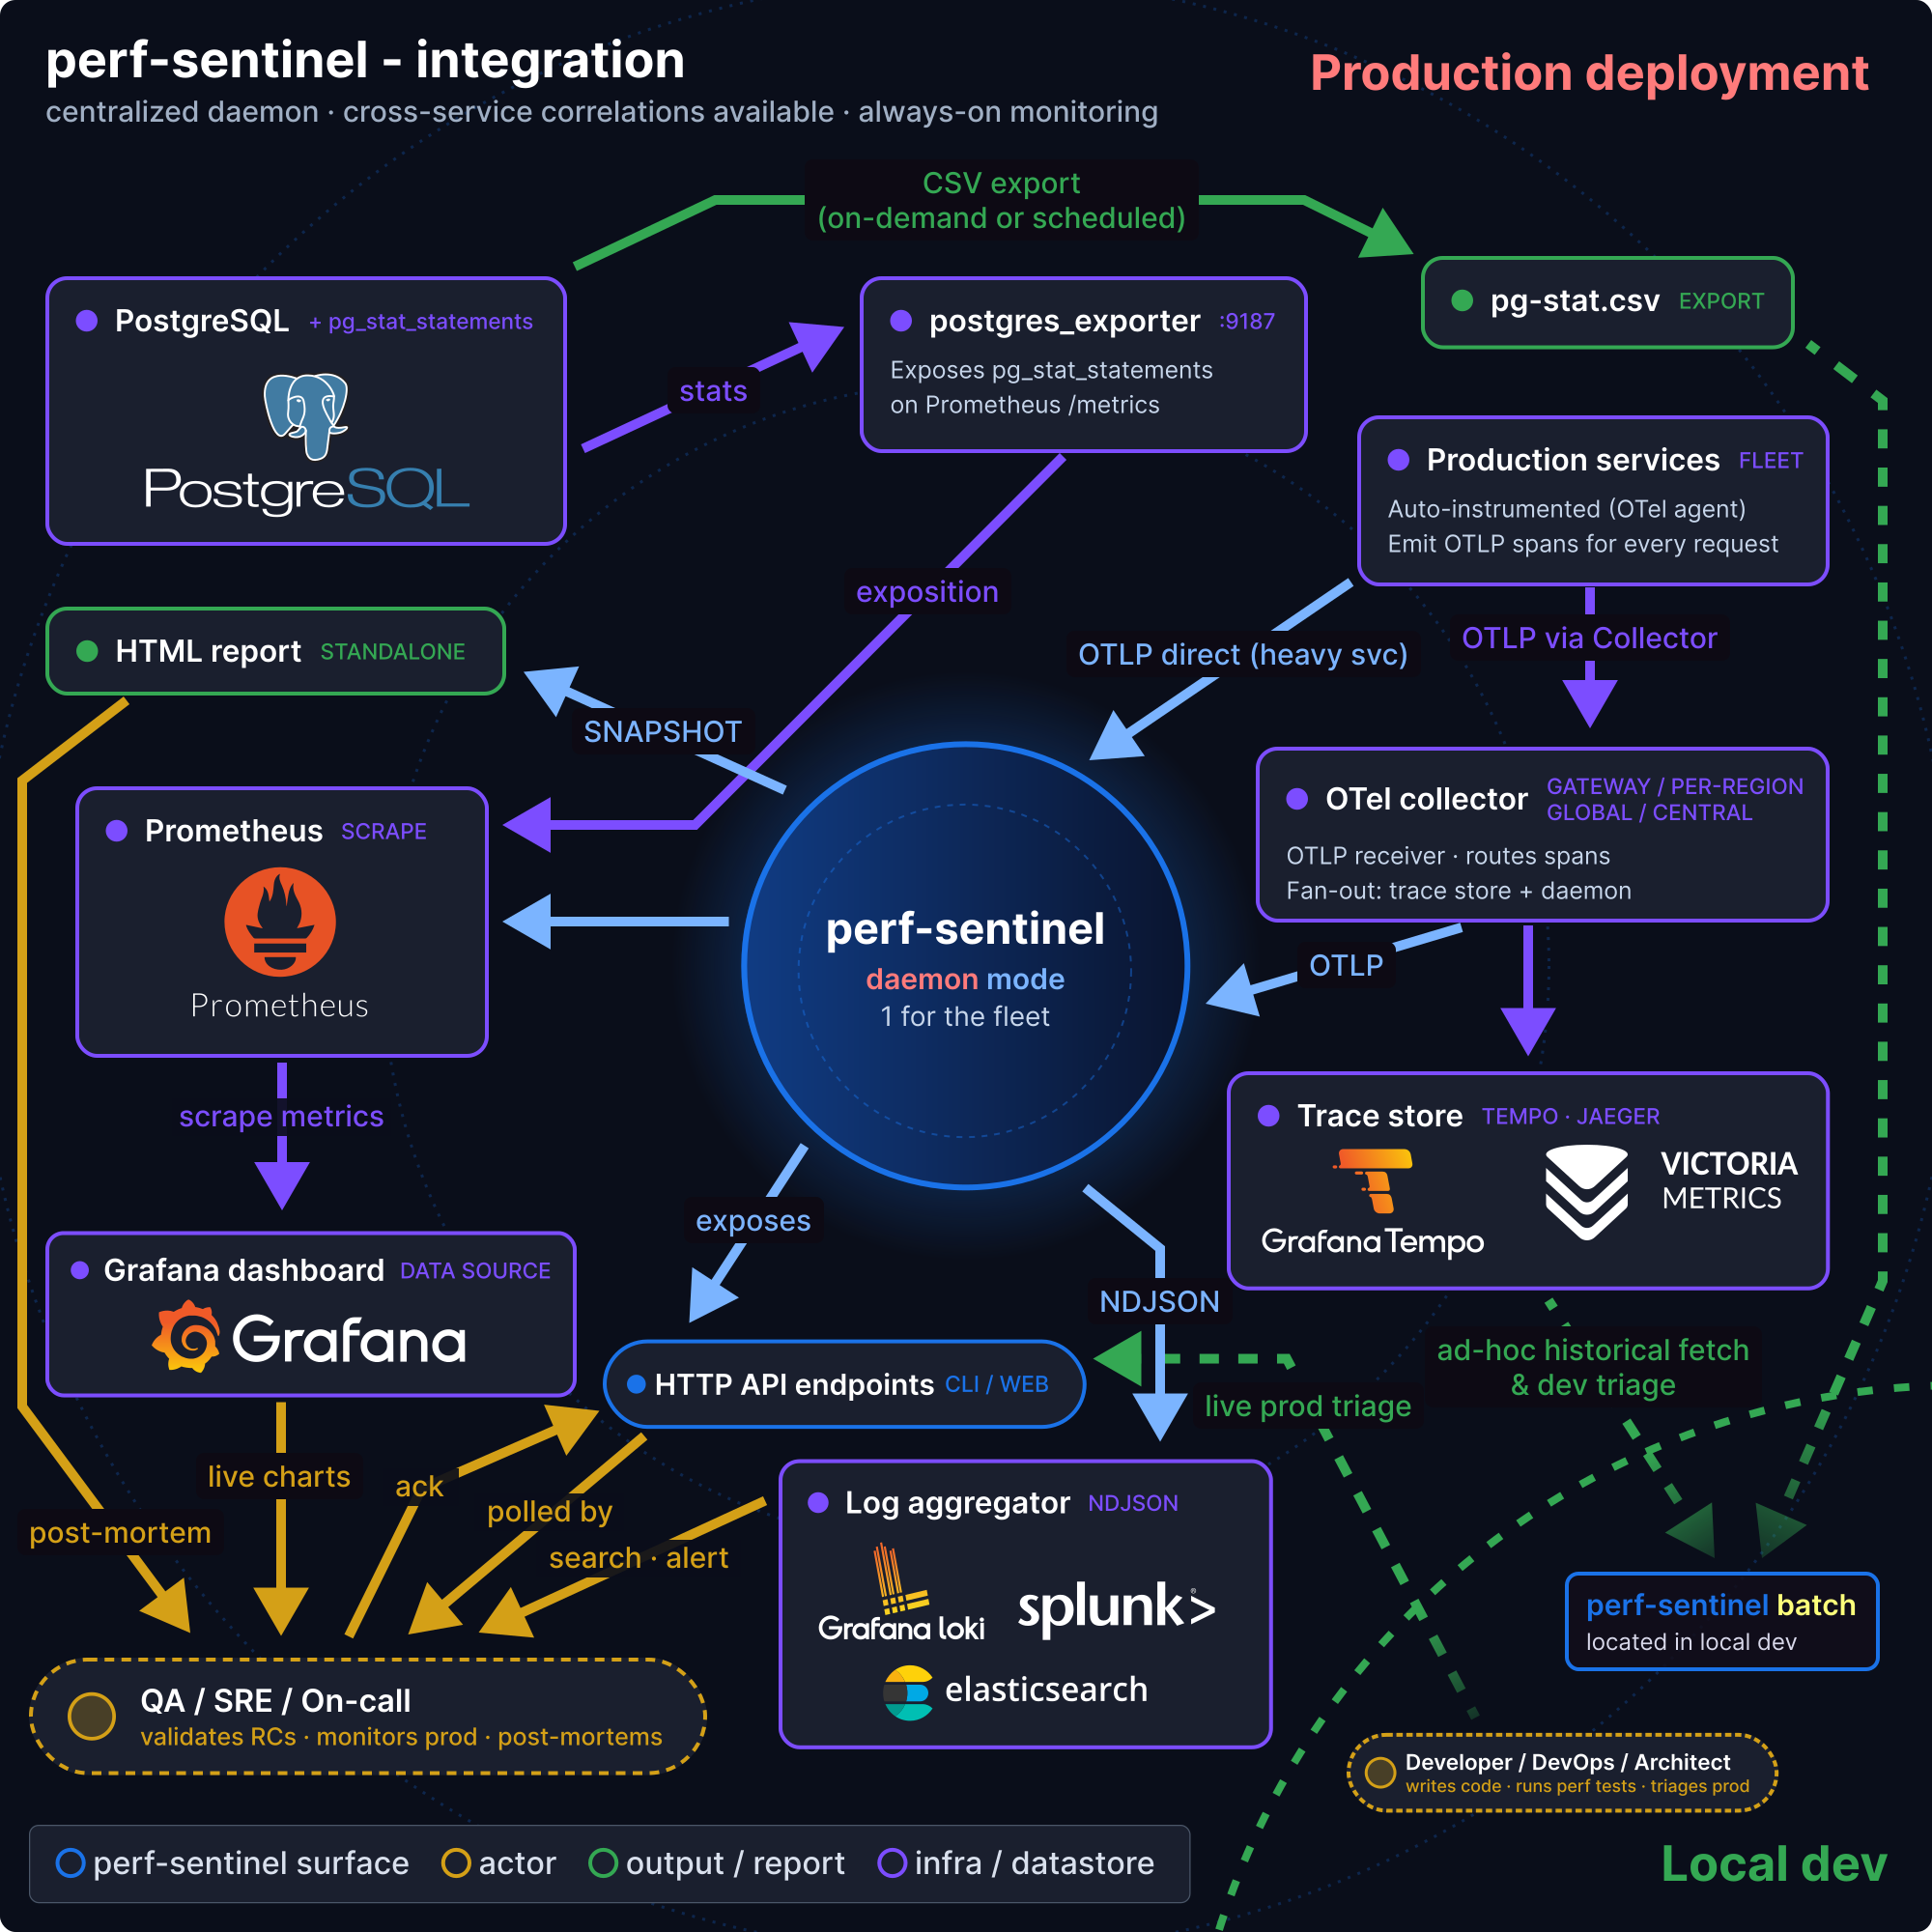
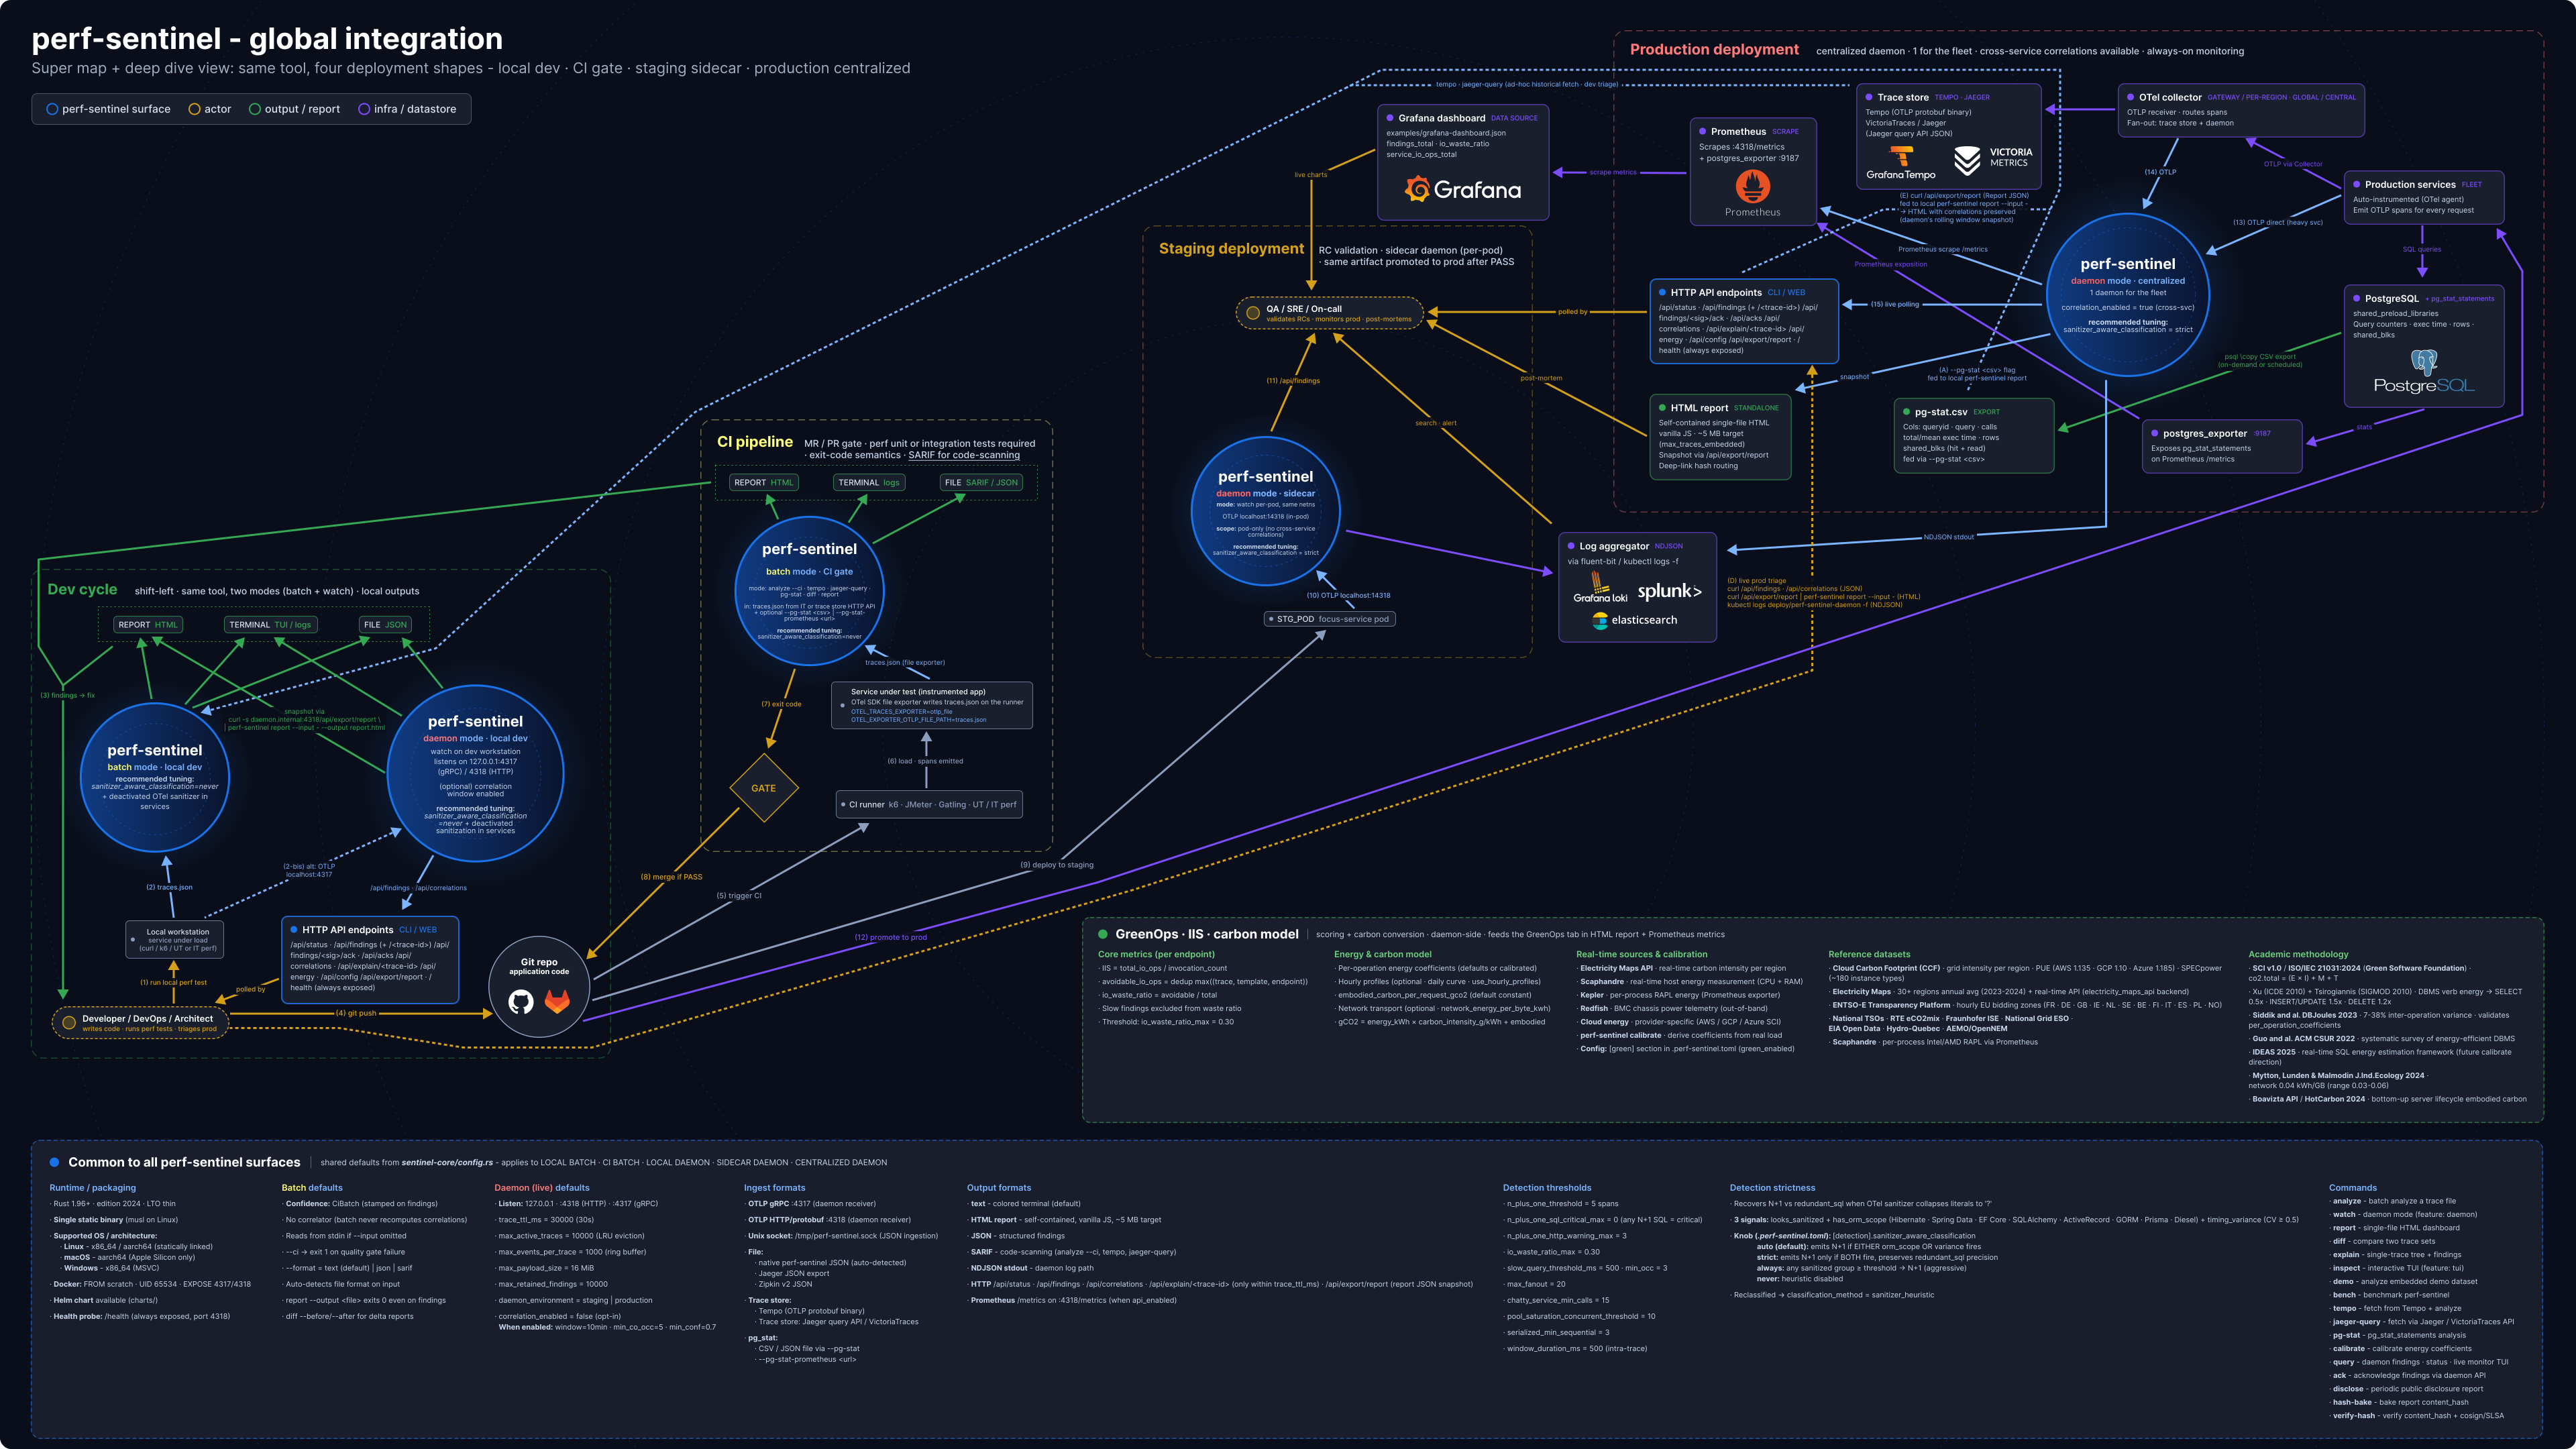
Choisissez le déploiement le plus léger adapté à l’endroit où vivent vos traces. Le collecteur central est un daemon unique avec état, donc des réplicas horizontaux exigent un load balancing par trace-id et ne partagent pas l’état de corrélation. L’échantillonnage de traces en amont (head ou tail) et le sampling_rate du daemon sous-comptent les détecteurs par répétition, et sous surcharge soutenue le daemon déleste des lots d’analyse entiers plutôt que de bloquer l’ingestion. Chaque lot délesté est compté dans les métriques.
perf-sentinel analyze --ci sur traces capturées, exit 1 au dépassement de seuil. Le gate le plus simple, rien de long-running./metrics Prometheus et l’API de query. Le daemon garde sa fenêtre de traces en mémoire : un arrêt propre en termine l’analyse, un arrêt brutal la perd.Hub:Recaps:Subscriptions renseigné, chaque période close est figée en un rapport envoyé par webhook signé et par e-mail. Les cartes à partager demandent le moteur 0.39.0 ou plus récent, Hub:Cards:Organisation renseigné par un admin et la permission cards.write (rôle member) : l’écran du récap affiche alors « Partager un résultat » sous les rapports, et chacun vérifie une carte sur perf-sentinel.dev/verifier ou avec perf-sentinel verify-card.Dev local
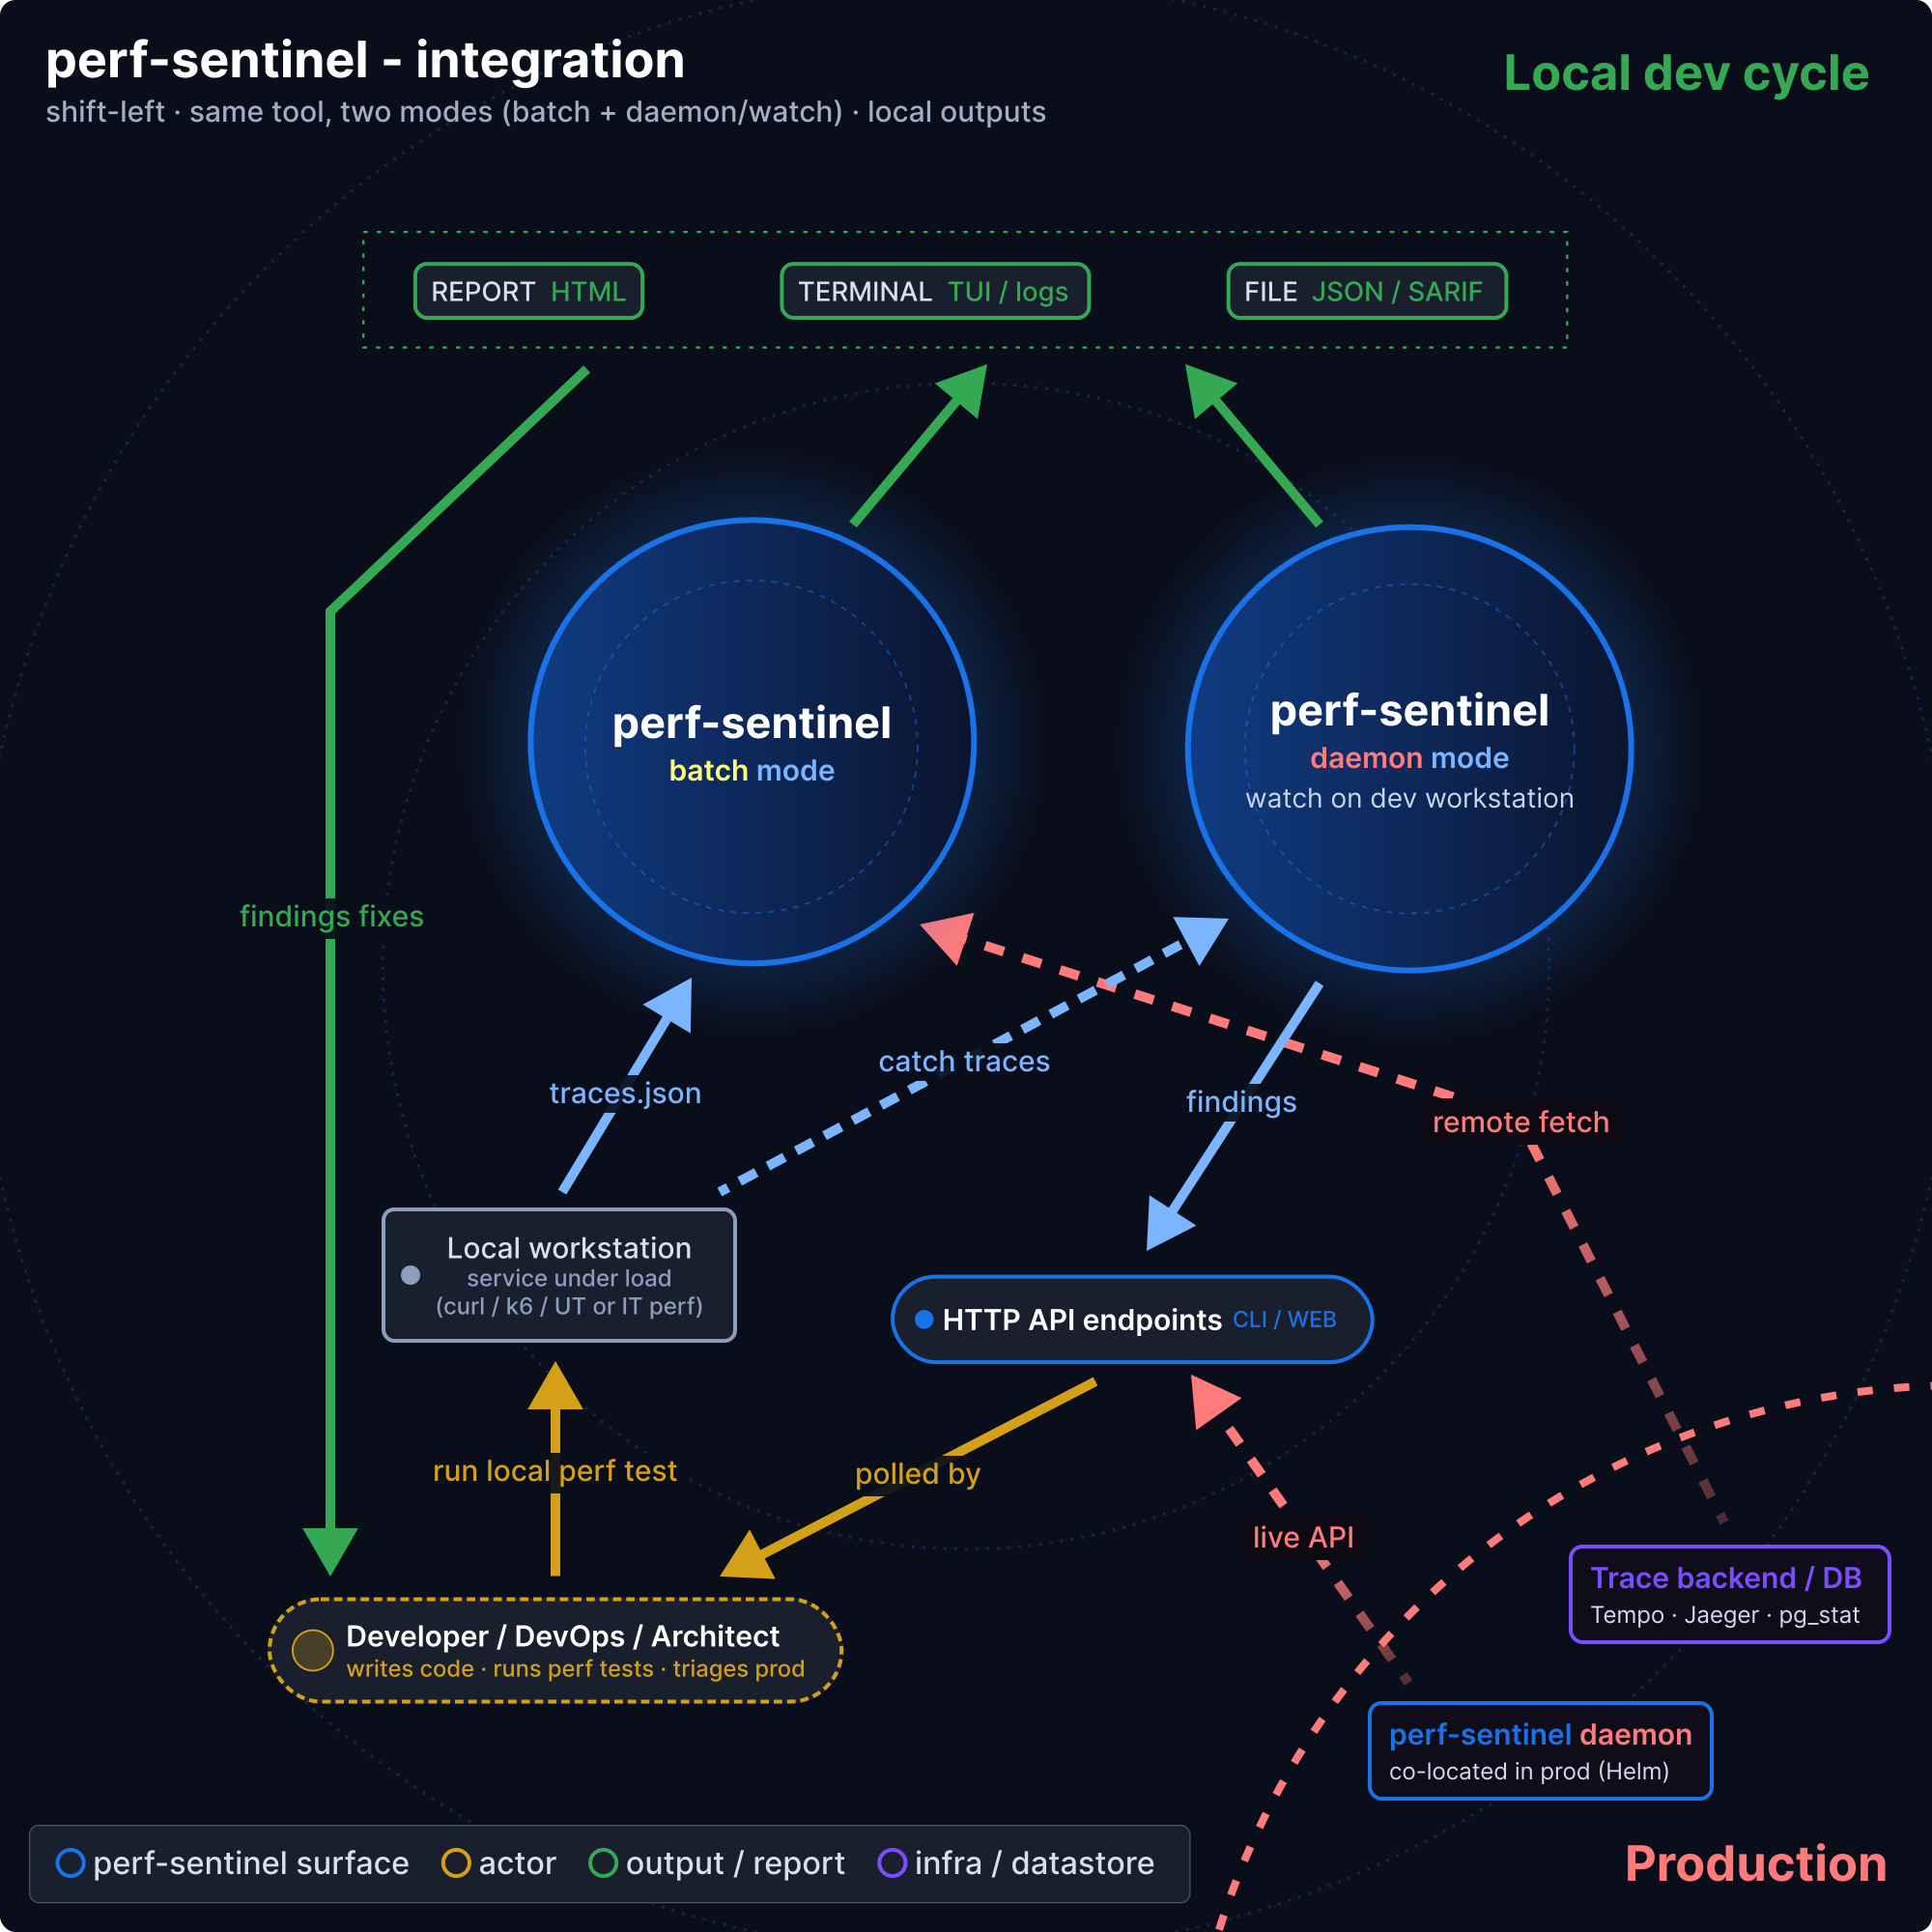
CI/CD
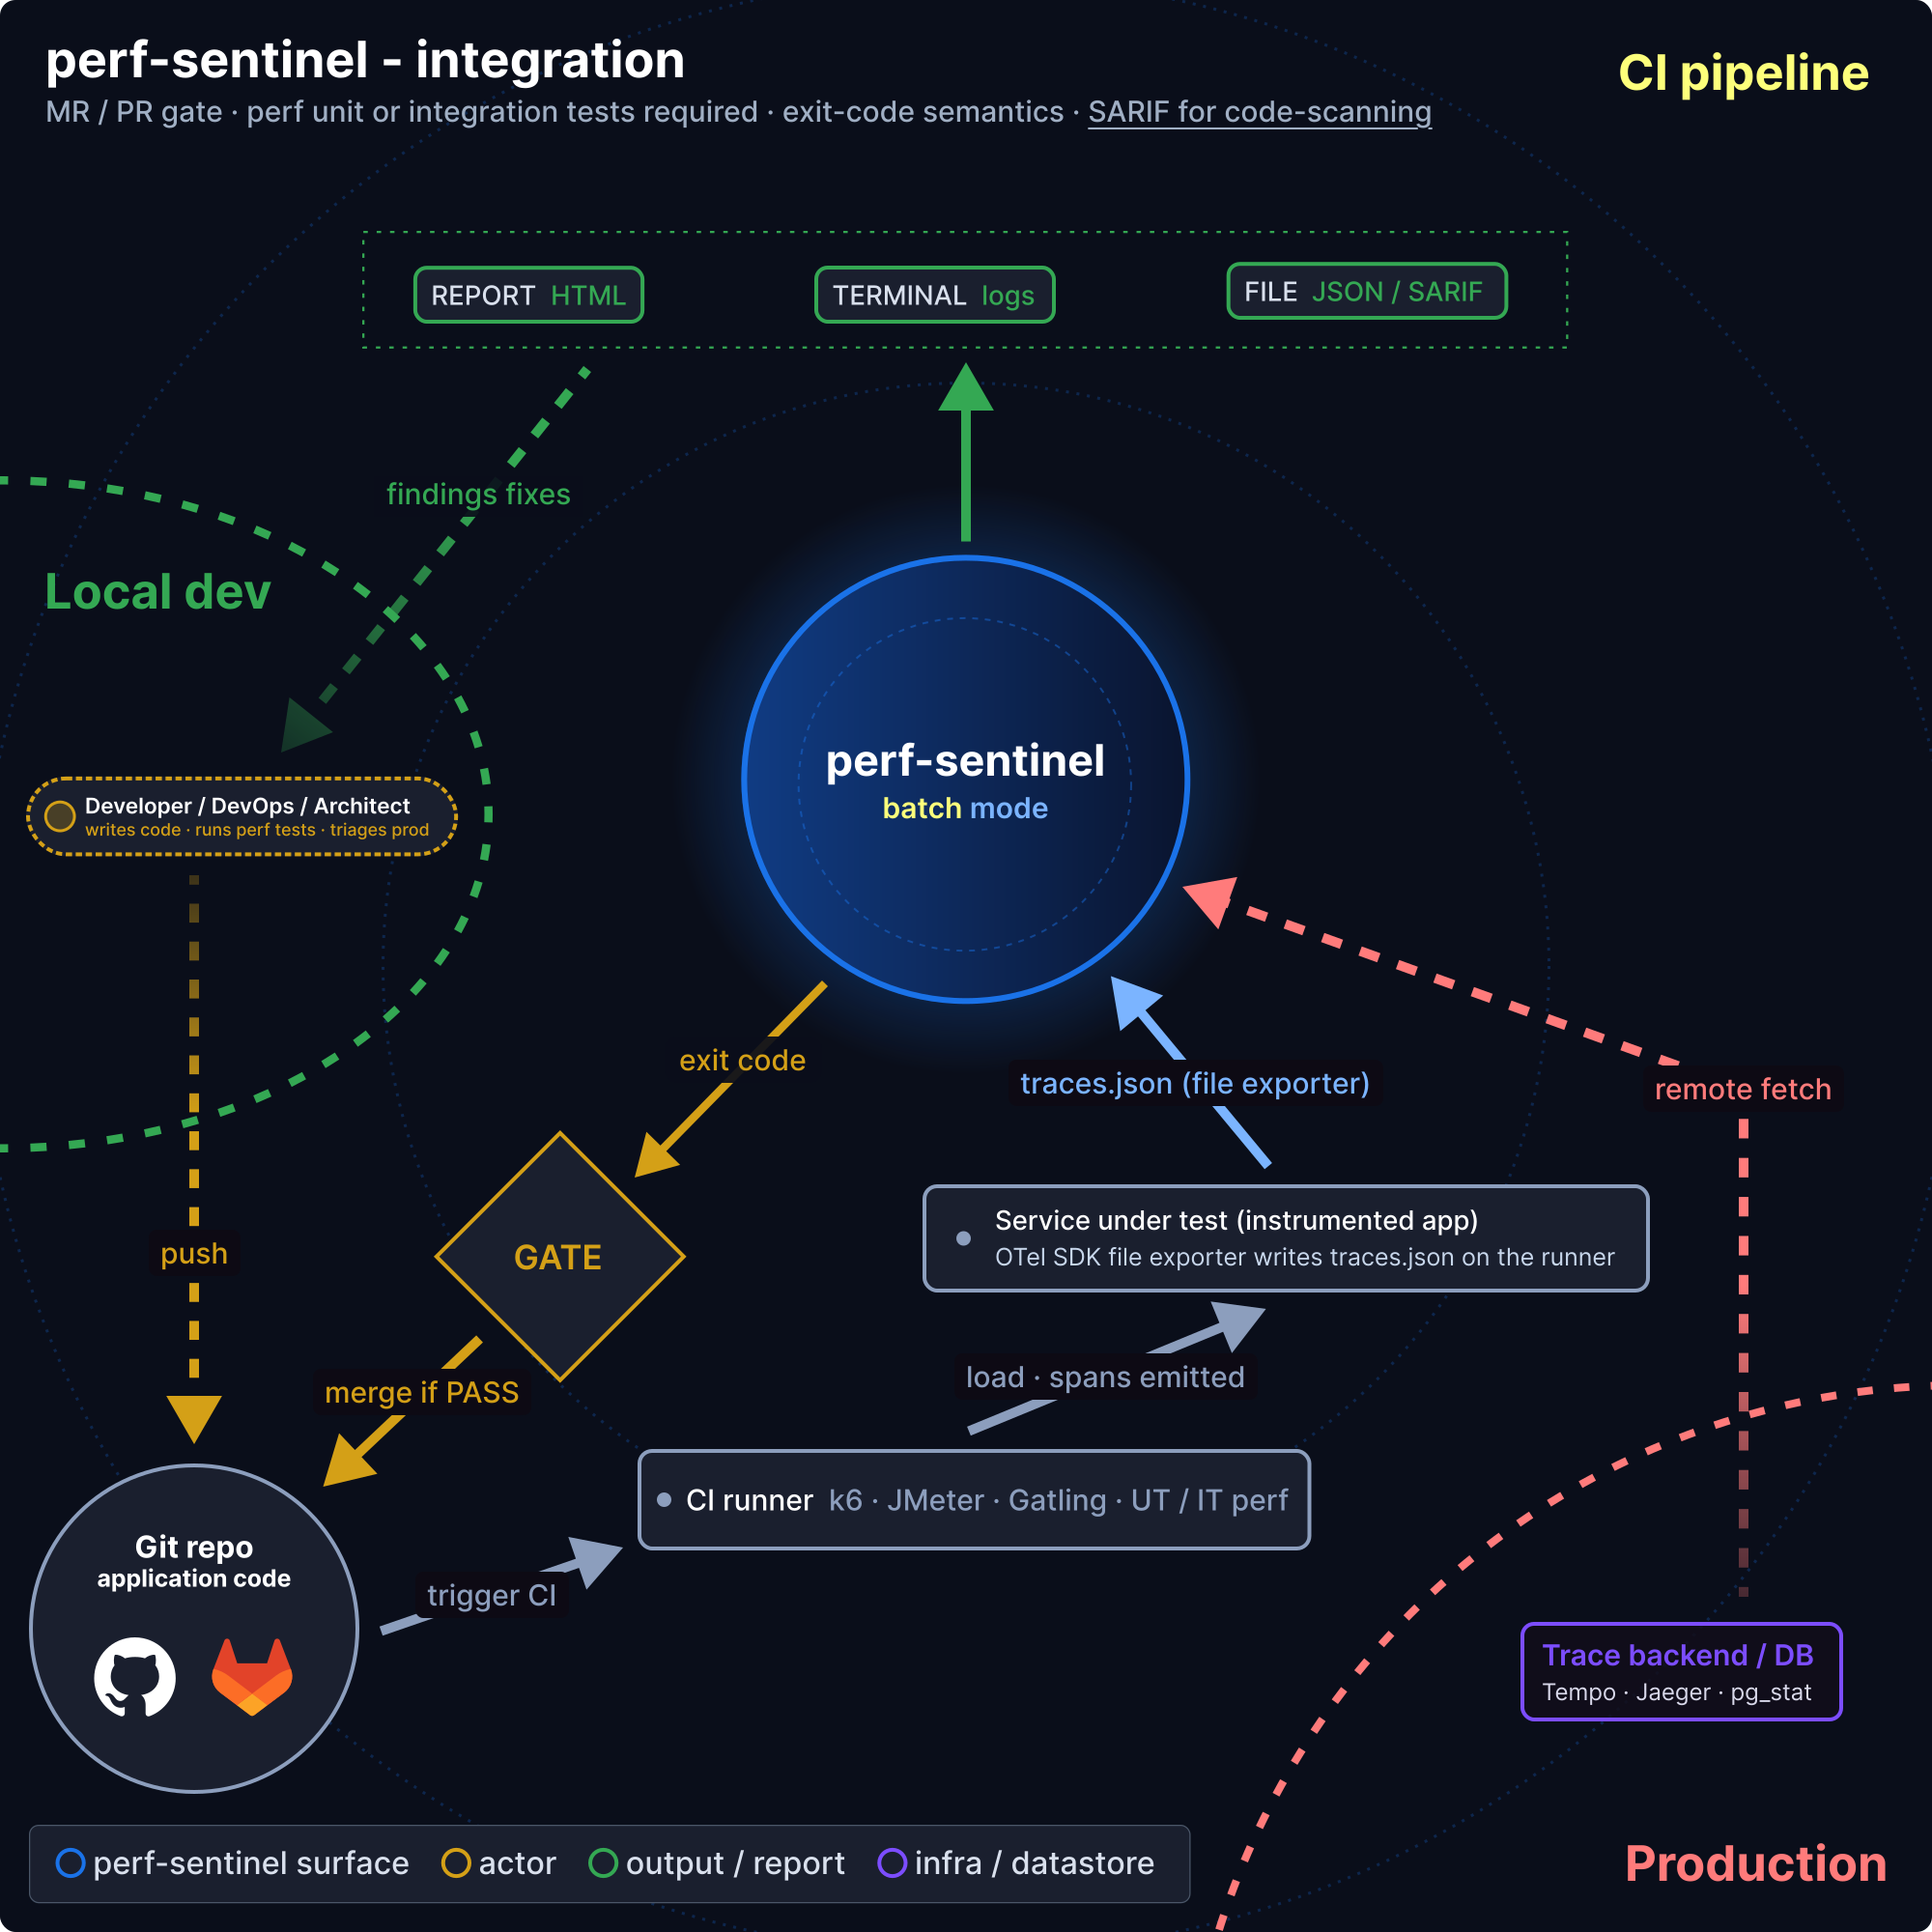
Staging
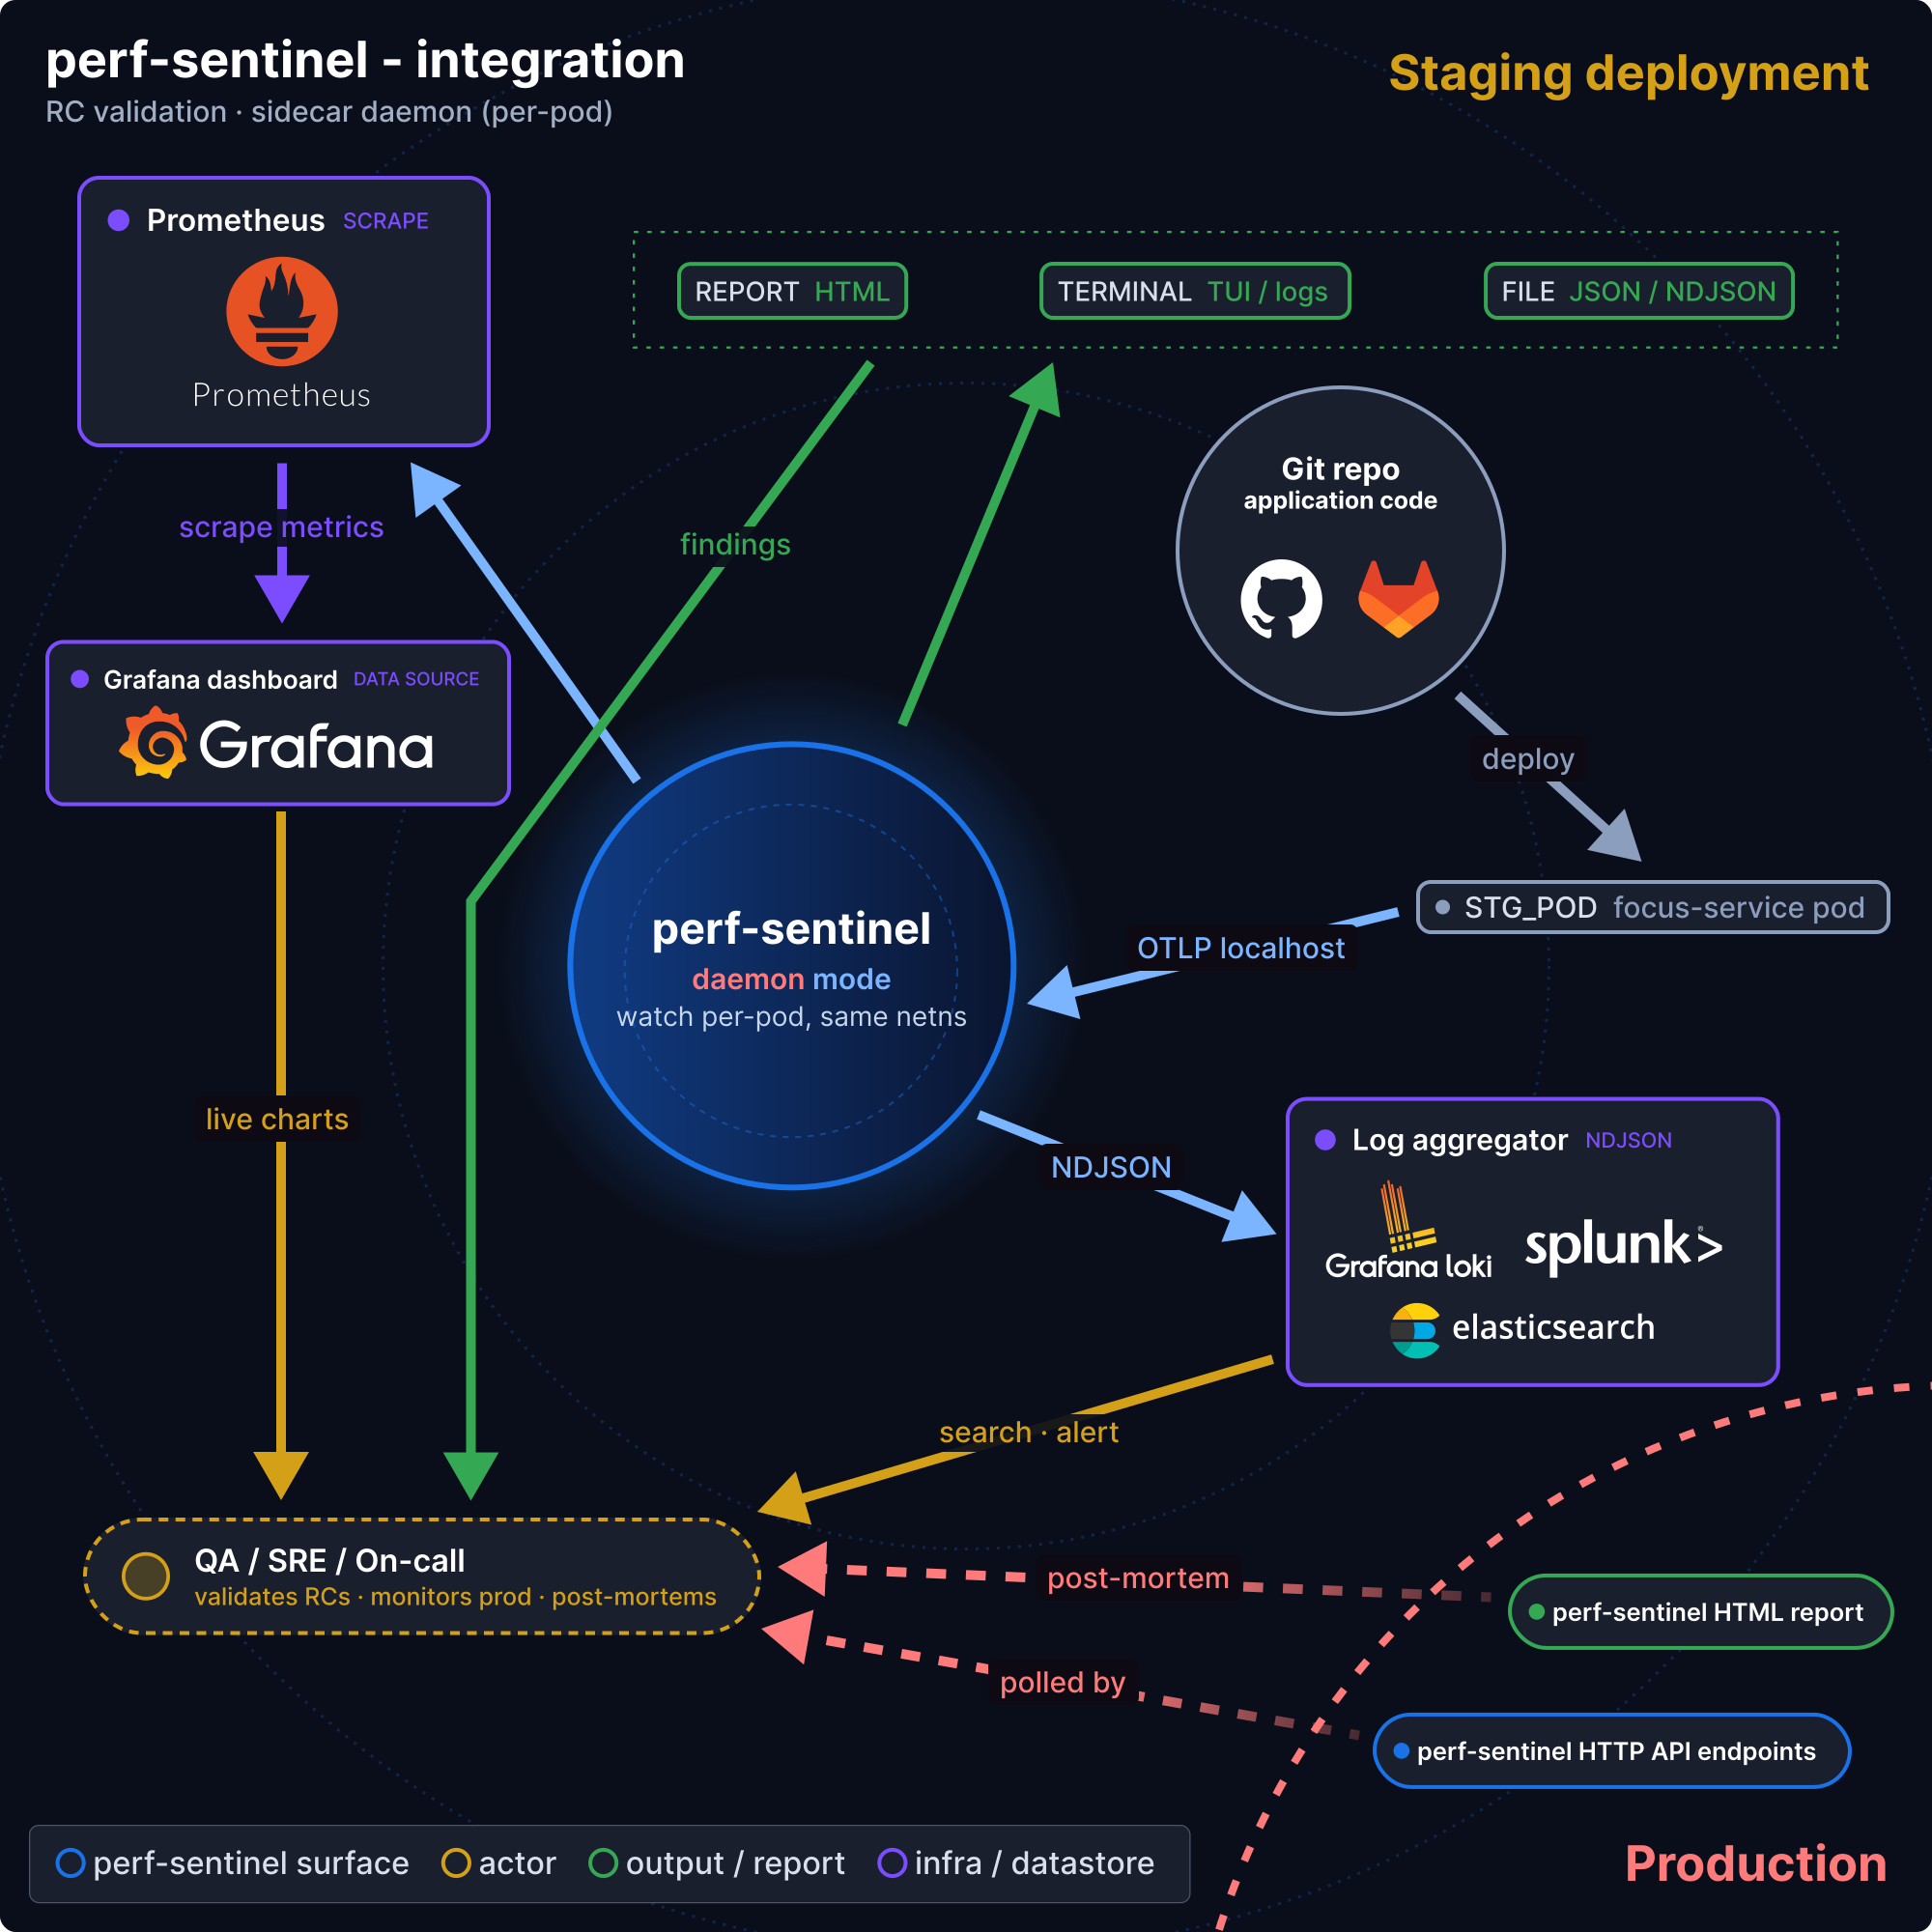
Production
GreenOps (transversal)
Vue d’ensemble
Moniteur opérateur live sur un daemon en marche, pour les DevOps / SRE, quatre onglets cyclés par Tab (hints Advisor, mix énergie/carbone, courbes Trends, santé des Scrapers) via perf-sentinel query --daemon <URL> monitor :
Deux dashboards Grafana d’exemple sont livrés dans le dépôt. Aucun n’est livré dans le chart Helm. Vous les importez dans le Grafana que vous exploitez déjà. Celui de vue d’ensemble lit les compteurs Prometheus /metrics, celui des findings lit l’API de query via le greffon Infinity, et les deux portent un badge Compatibility qui signale quand le daemon qui les alimente est plus ancien que ce que leurs panneaux demandent. Une rangée repliée History (Hub) lit PerfSentinelHub à la place, sur la plage du sélecteur de temps, là où le tampon du daemon est borné par le volume et ne remonte pas :
Confidentialité & sécurité
Perf Sentinel tourne dans votre réseau et n’émet aucun appel sortant que vous n’avez pas configuré.
Chaîne d’appro. & releases
Chaque GitHub Action est épinglée à un SHA de commit de 40 caractères, l’image de production est FROM scratch, Cargo.lock est commité et audité quotidiennement par cargo audit, et les permissions de token des workflows sont en lecture seule par défaut. Les tags de release sont signés, et les binaires portent une provenance SLSA attestée via Sigstore.
Les publications suivent une procédure documentée, gardée par un run obligatoire du lab de simulation, le chart Helm étant versionné en lockstep. Les binaires de release portent une provenance SLSA (Build niveau 2, Sigstore + Rekor) et des données cargo-auditable embarquées (cargo audit bin), et chaque release publie un SBOM SPDX attesté sous le prédicat SPDX. Dependabot ouvre des PR hebdomadaires groupées.
Documentation détaillée
Chaque sujet ci-dessus est couvert en intégralité dans la référence. Accès direct à une page :
.perf-sentinel.toml/metrics